

Представили?
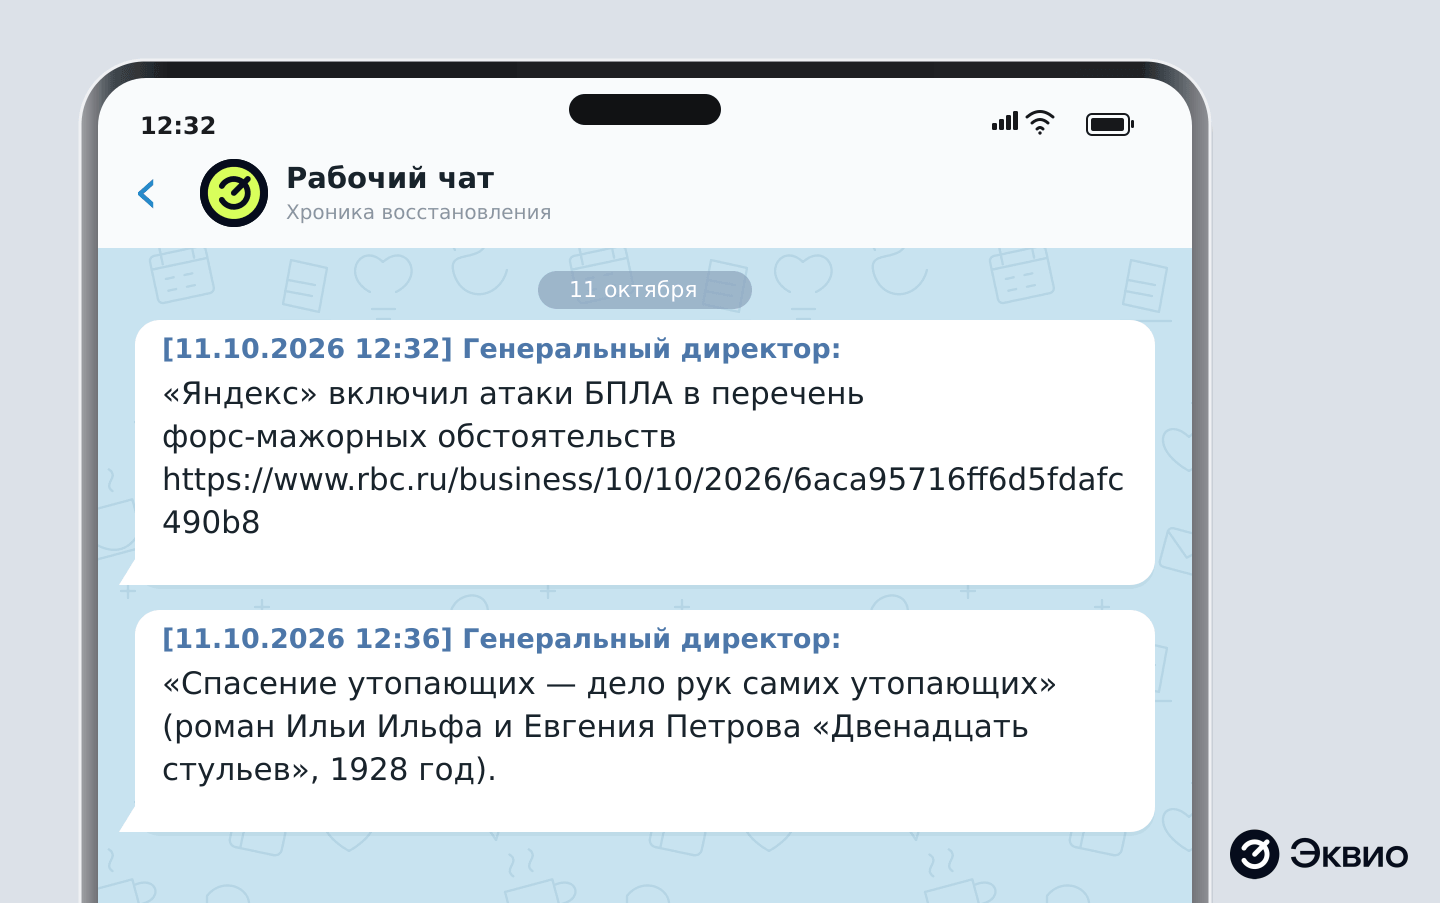
А если добавить, что это уже третий дата-центр Яндекса, подвергшийся атаке за неделю, и там были данные наших клиентов, ИТ-продукты и инструменты разработки, которыми команда пользуется каждый день?
Ещё трудно представить?
Хорошо, представьте, что в один момент все ваши банковские счета, фото с телефона и документы с вашего компьютера пропали, а вы остались наедине с запрещенным мессенджером, работающим через VPN, но без интернета.
Но любителей драмы хочу немного разочаровать. Криков, экстренных совещаний и брейнштормов ранним воскресным утром не было.
В голову пришло только популярное выражение «Поздно пить боржоми, когда печень отвалилась».
Как мы готовили запасной маршрут
Я генеральный директор и основатель Эквио. Мы делаем платформу для обучения и развития сотрудников. Обычно продаём её как SaaS — сервис под ключ: настраиваем, обновляем, чиним и улучшаем. Клиент создаёт контент, организует обучение и смотрит аналитику результатов.
В нашем бизнесе важно, чтобы сервис бесперебойно работал, а данные надёжно хранились. Весь мир долго шёл в сторону оптимизации и удешевления ИТ-инфраструктуры: проще и дешевле размещать сервисы и данные в специализированных дата-центрах. Их оборудование и системы защиты помогают соблюдать требования безопасности и законодательства, снижать риск сбоев.
Мы были одними из первых клиентов Yandex Cloud. Облако давало нам инфраструктуру и сопутствующий сервис, позволяя сосредоточиться на развитии продуктов. Вместе с нашим бизнесом росли и возможности провайдера.
При этом мы брались за крупных клиентов со сложными процессами и очень придирчивыми ИТ-безопасниками. Они буквально выворачивали нас наизнанку и всегда имели своё мнение о том, как должна выглядеть инфраструктура. Так мы научились работать с другими крупными провайдерами и поддерживать частные облака клиентов. Но основным партнером для большинства оставалось Яндекс Облако.
Здесь важно разделять сохранность данных и доступность сервиса: наличие бэкапа еще не означает, что платформа сразу заработает. За время нашей работы с 2014 года было многое: поломки, сбои, человеческие ошибки. Но я не помню случая, когда платформа не работала для всех клиентов более часа.
Резервные копии данных и контента создавались ежедневно и хранились в нескольких дата-центрах Яндекса. Мы резервировали дополнительные мощности, чтобы при повреждении одного центра было куда развернуть копии.
Схема выглядела надежной. Пока один из клиентов не задал фантастический тогда вопрос:
«А что будете делать вы, если все дата-центры Яндекса полностью загнутся?»
Ну у нас же есть план Б! Действующие контракты с другими провайдерами и возможность переехать. Уже несколько лет мы дополнительно копировали данные особо требовательных клиентов за пределы основного провайдера. А в сентябре, когда беспилотники начали летать по дата-центрам, снова собрались с командой и обсудили готовность к такому сценарию.
Теперь удобство и дешевизна инфраструктуры уступают по важности сохранности данных и доступности сервиса. Пришло время децентрализации и готовности к быстрым переездам для всего бизнеса.
Почему одного бэкапа мало
Поясню на простом примере: вы живёте в прекрасном отеле и на всякий случай собрали тревожный чемоданчик. Он позволит расположиться в другом номере, если вас затопит сосед. Но если сгорит весь отель, чемоданчик, оставленный на ресепшене, уже не поможет. Нужен запас вещей в другом месте.
Мы такой дополнительный чемоданчик собрали заранее. Но возникает следующий вопрос: а куда переселиться? Ждут ли вас в другом отеле, забронирован ли номер, примут ли с вашим багажом? Или там уже очередь из погорельцев?
Поэтому бэкапы и их хранение — только часть подготовки. Нужны договоренности, резервные мощности и понятный план переезда. А самое важное — профессиональная команда, которая знает, как его выполнить.
Как проходило восстановление
Ниже приводим хронологию воскресной переписки. Вместо имен коллег оставили должности.
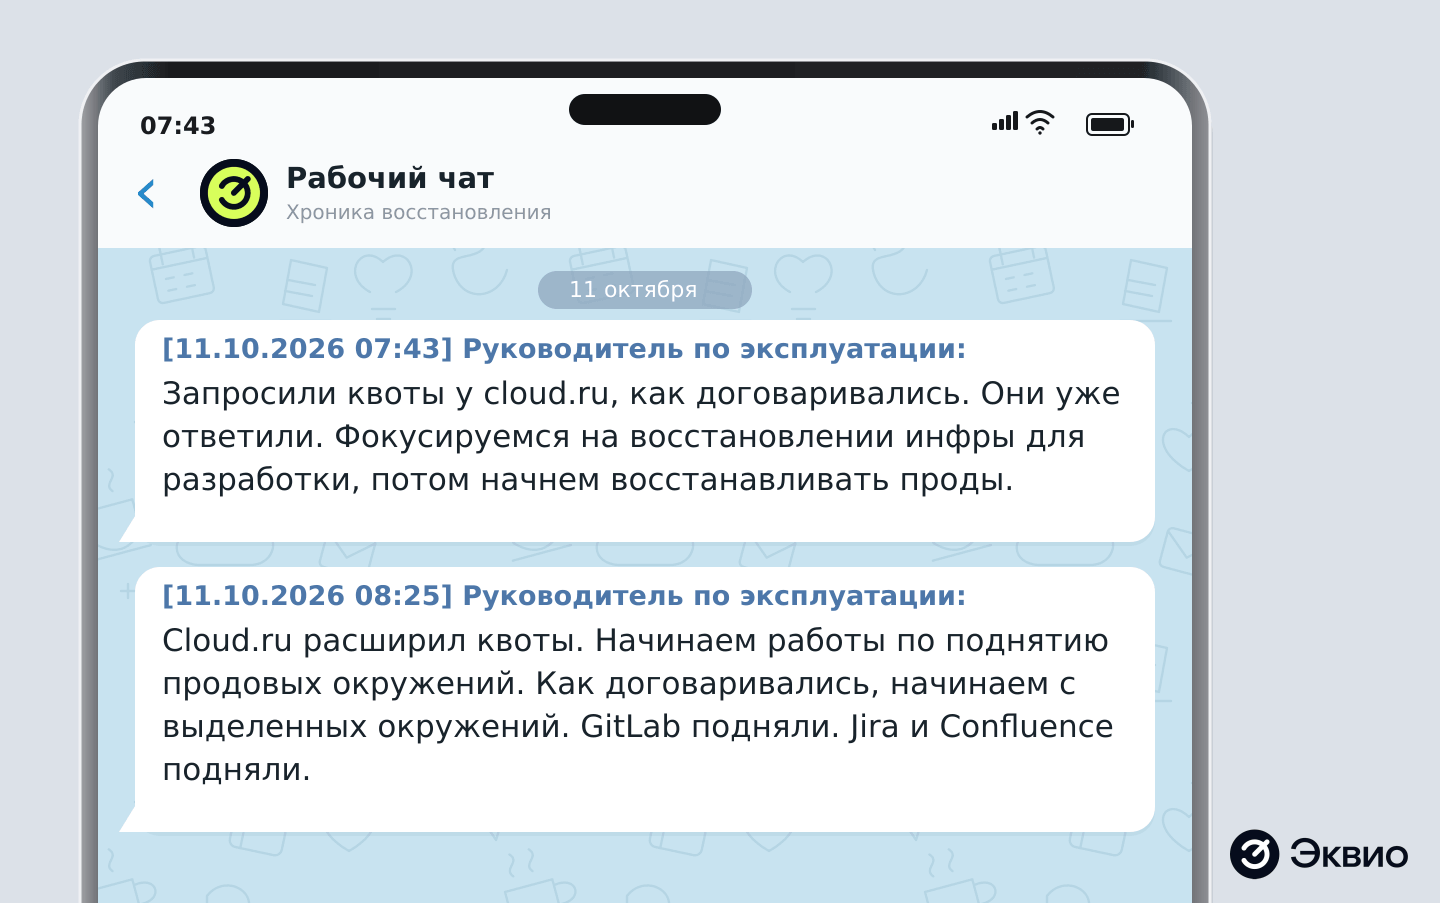
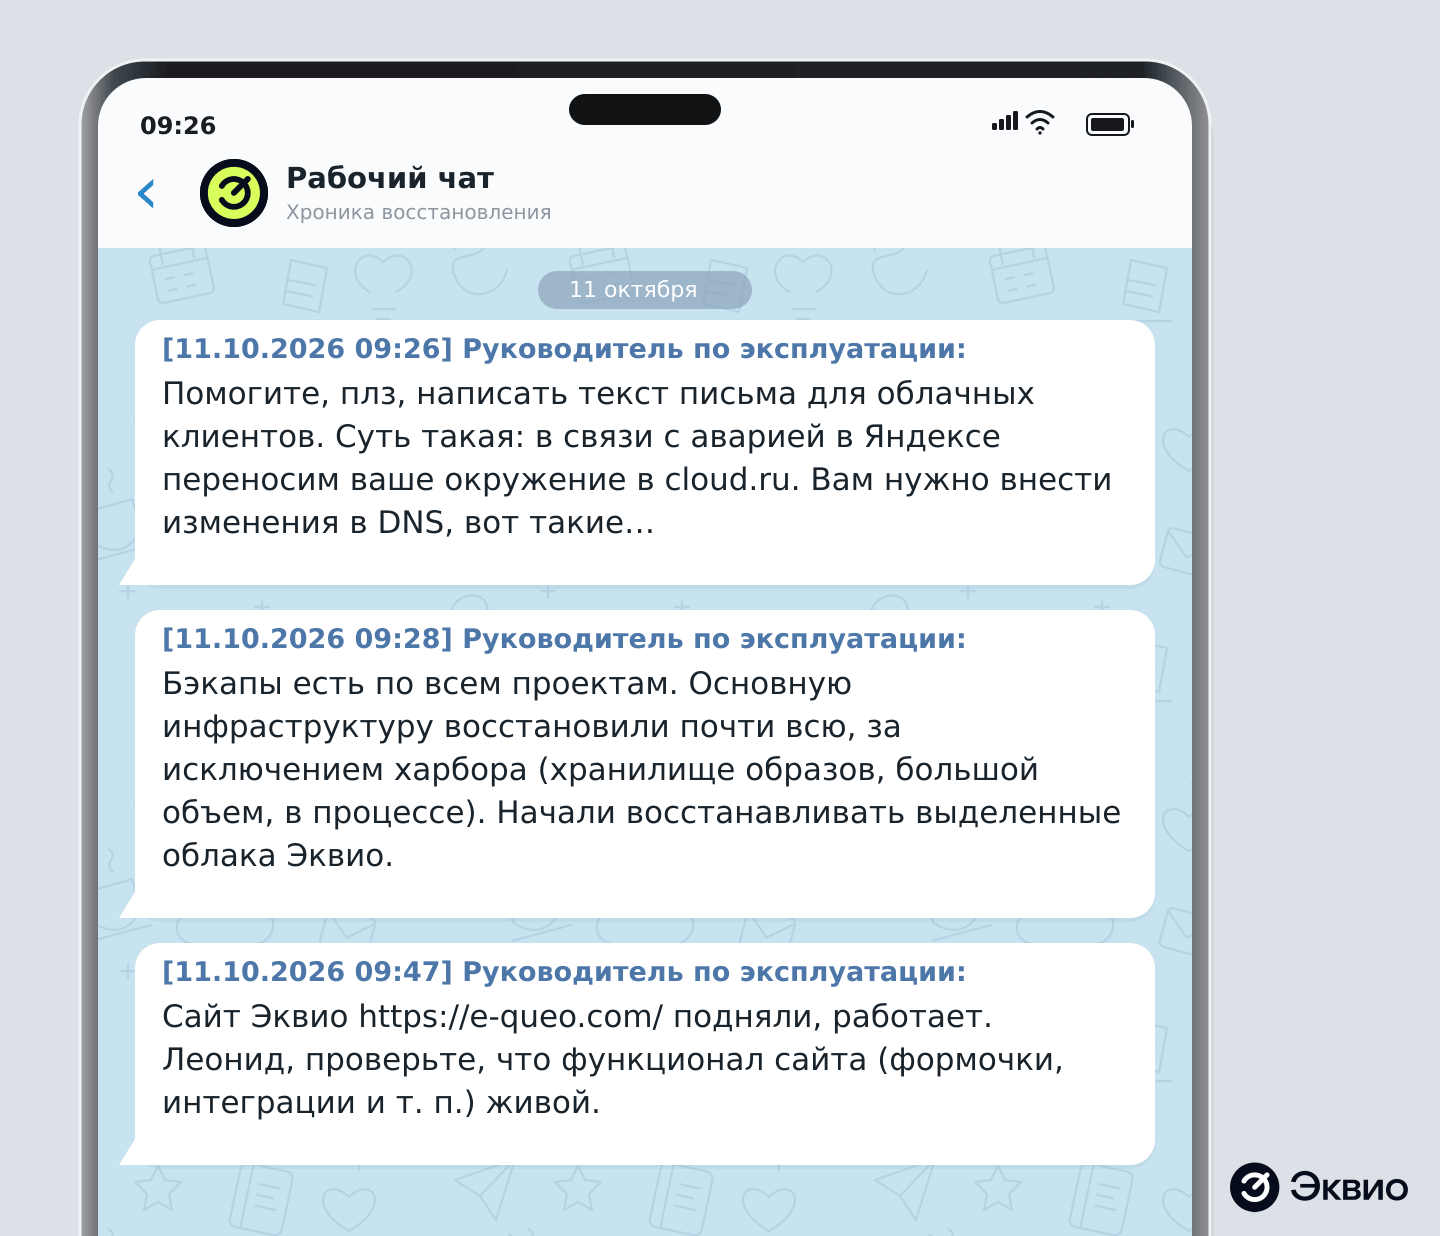
В 09:47 коммерческий директор пишет о публикации официального сообщения клиентам по всем каналам связи:
«Держим вас в курсе. Восстанавливаем данные. Резервные копии есть — восстанавливаем из них. Общее облако: действий не нужно. Возвращаем работу платформы централизованно. Казахстан и зарубежные клиенты: сервисы работают в штатном режиме».
Дальше стараемся связаться с клиентами лично и разъяснить ситуацию.
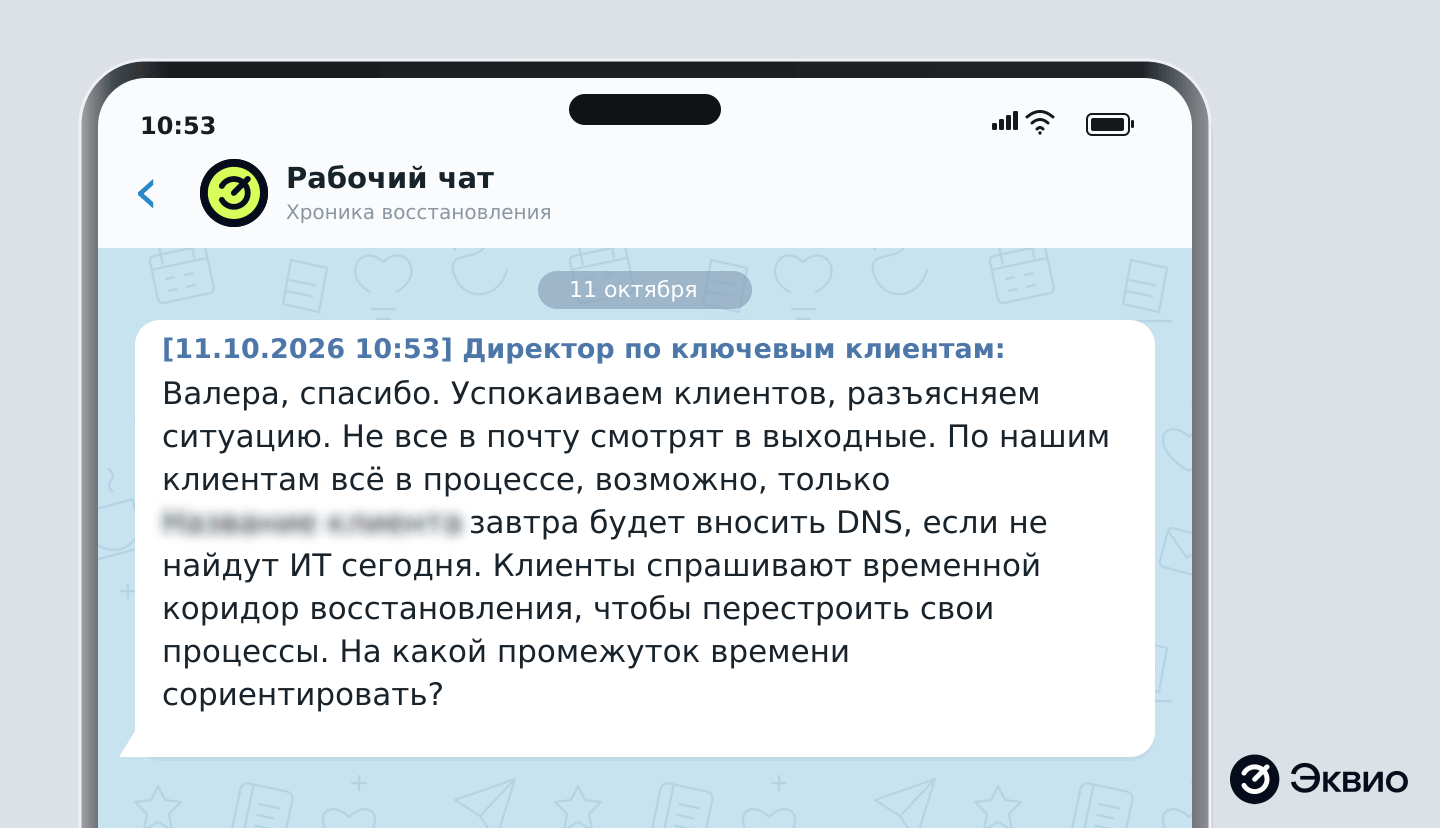
В 10:58 команда присылает статус восстановления:
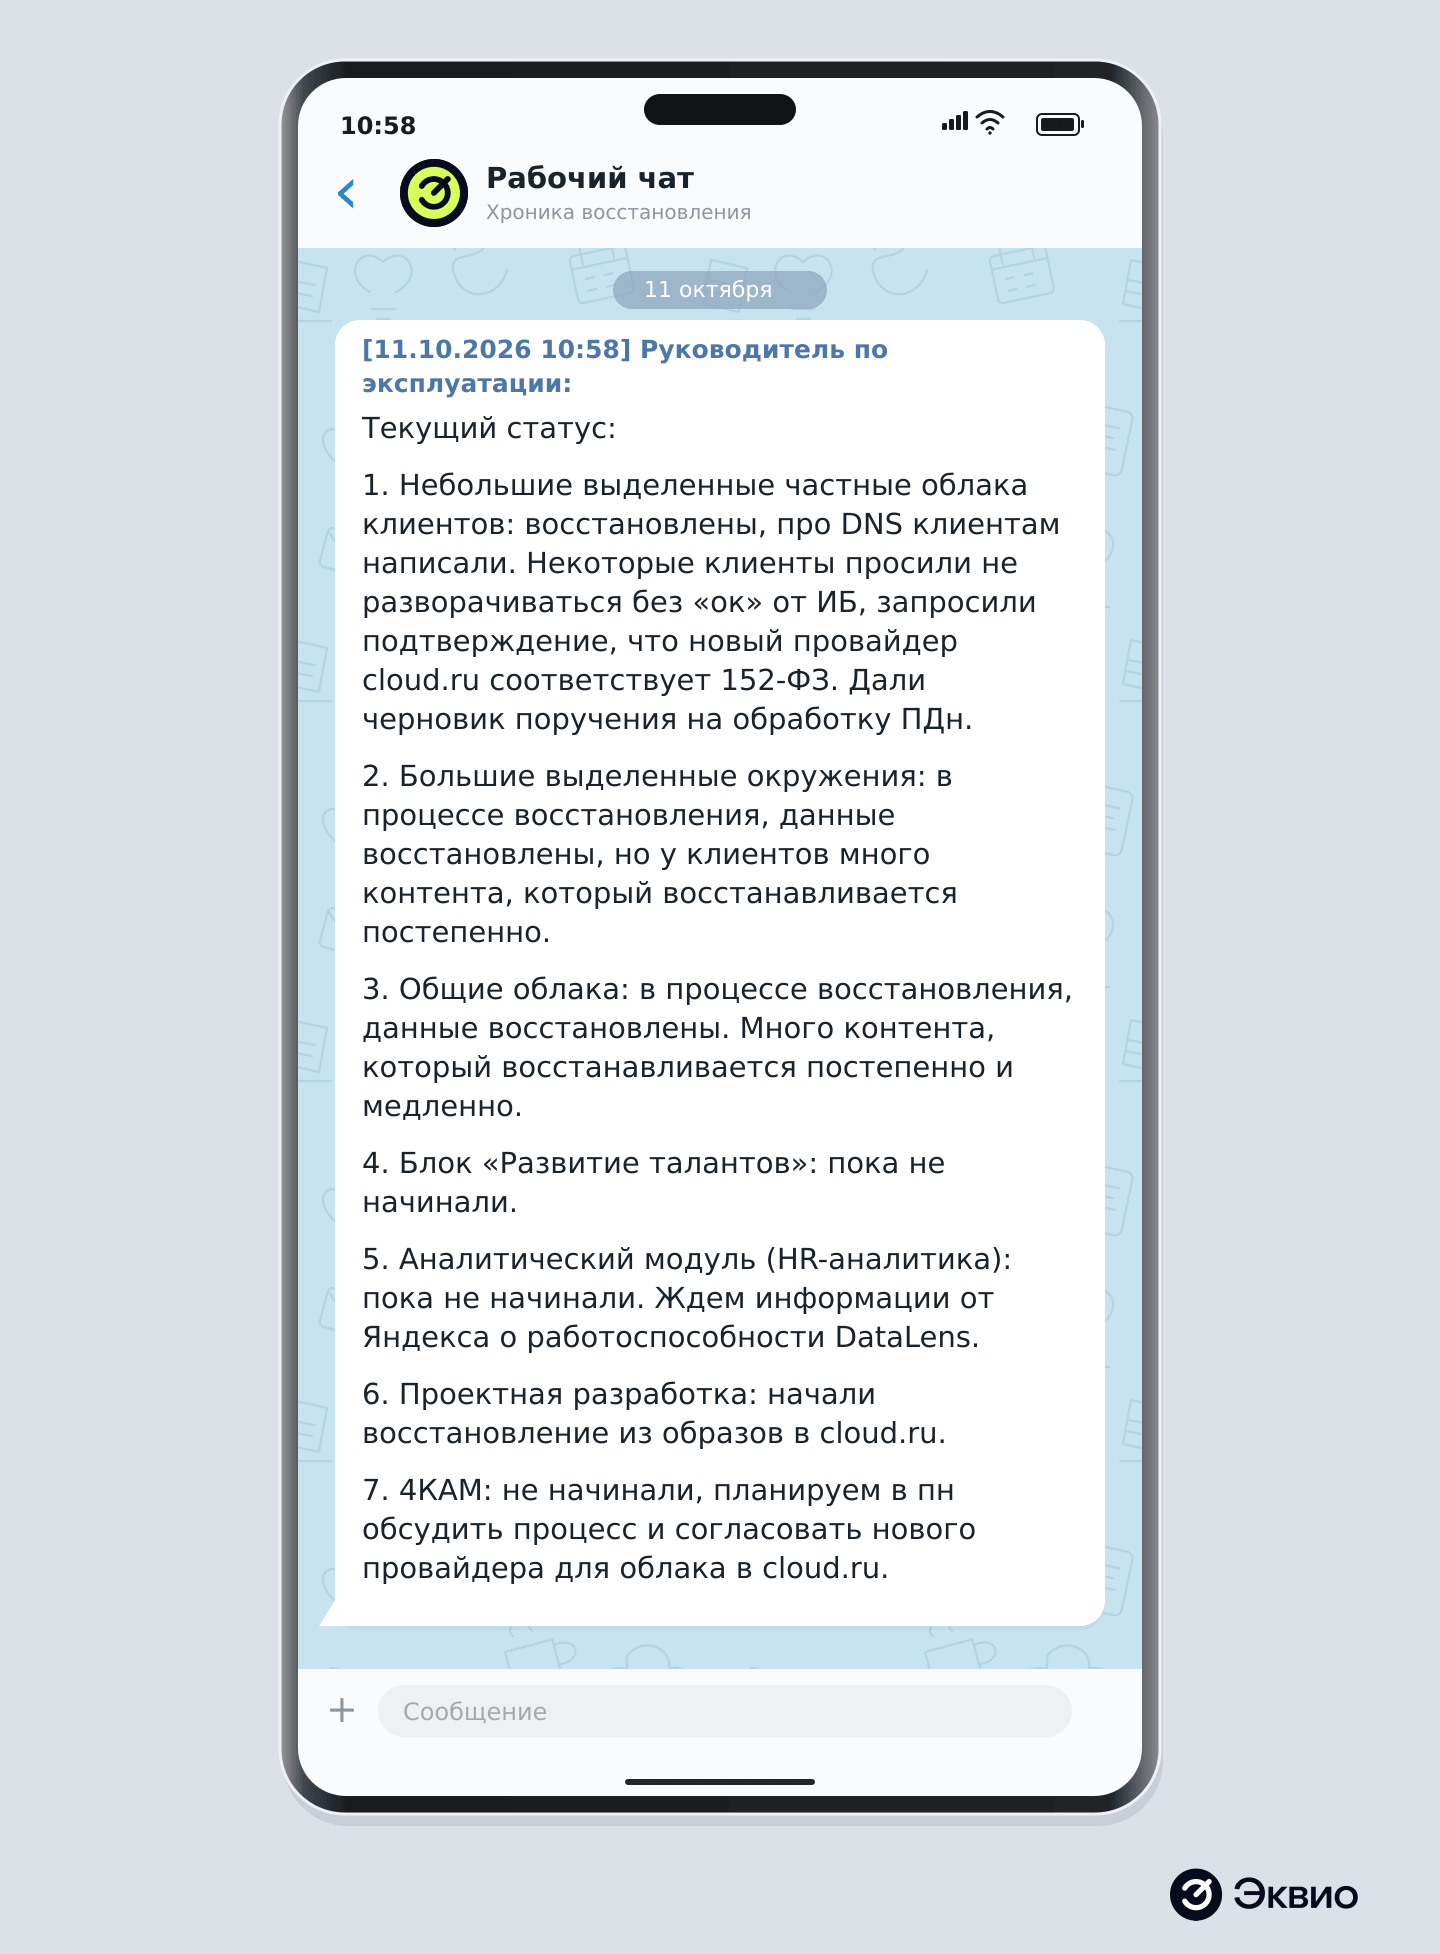
Дальше были детали: что уже работает, а что надо починить позже. К позднему вечеру команда из пяти DevOps-инженеров восстановила работу нескольких клиентских окружений и разошлась отдыхать. В остальных продолжался перенос большого объёма контента — уже ночью, автономно.
Что удалось восстановить за день
Было затронуто 12 продуктовых окружений и 320 клиентов. Плюс связанные сервисы: блок «Развитие талантов», HR-аналитика, пять серверов проектной разработки и около 40 клиентских сайтов-лендингов.
За 6,5–7,5 часа мы восстановили техническую инфраструктуру клиентских окружений. Доступ пользователей возвращался постепенно, по мере восстановления данных и переключения DNS. Последние выделенные окружения стали доступны 12 октября: требовалось обновить DNS-записи на стороне клиентов. Отдельные настройки, интеграции и авторизации, требующие совместной работы с клиентами, на момент написания статьи мы еще доделывали.
На небольших выделенных облаках контент восстановился практически сразу. У самых крупных клиентов — за 34,5 часа от начала работ.
Точка восстановления — 10 октября, 00:00. Это целостный бэкап всех систем. Резервное копирование за 11 октября не успело завершиться на всех окружениях из-за ночного инцидента. Целостность восстановленных данных проверили по контрольным суммам — все сошлись.
Что нас спасло и что будет дальше
Нас спасло резервирование данных вне основного облачного провайдера. Помогли и заранее подготовленные договорённости с альтернативными поставщиками, и опыт работы с ними. Команда знала порядок действий и распределение ответственности — план аварийных работ уже существовал.
Такая устойчивость стоит денег: резервные мощности, хранение копий, трафик на переброску контента, работа команды в выходные. Раньше это больше походило на страховку от маловероятного сценария. Теперь, на мой взгляд, такой подход становится новым стандартом рынка. Уровень резервирования — отдельный параметр сервиса, и его стоимость надо обсуждать с клиентами открыто.
А утро понедельника началось с сообщения, невольно вызвавшего улыбку у нашей техподдержки:
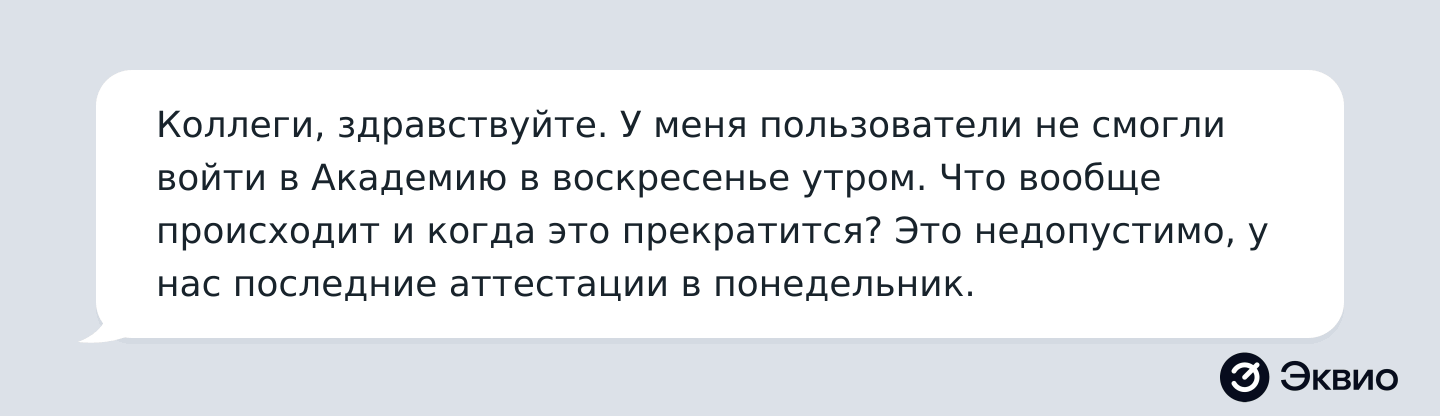
И ведь клиент прав. Ему неважно, сколько дата-центров вышло из строя, сколько часов работали инженеры и как сложно было всё восстановить. Мы извинились и сказали, что всё уже работает, аттестации проводить можно.
Приятно осознать, что мы нужны своим клиентам. Значит, ребята в воскресенье поработали не зря.
Наша команда спасла бизнес не потому, что в воскресенье совершила невозможное, а потому, что до воскресенья сделала всё необходимое.
P. S. Спасибо команде за прекрасные выходные ♥


 Если вы уже текущий клиент, пожалуйста,

 Если вы уже текущий клиент, пожалуйста, напишите на
0 комментариев
Здесь пока ничего нет. Станьте первым, кто оставит комментарий